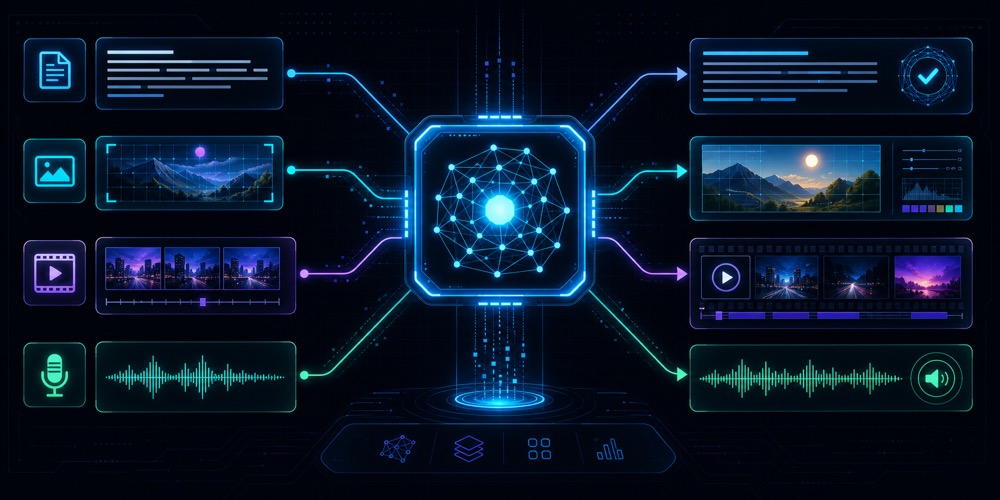
AI bilan ishlash uzoq vaqt matndan boshlanardi: promptModelga berilgan ko‘rsatma yoki topshiriq matni. Javob sifati ko‘pincha shu kirishga bog‘liq bo‘ladi. yozasiz, model javob beradi. Keyin rasm generatsiyasi, ovozli suhbat, video tahlil va fayl bilan ishlash alohida mahsulotlar sifatida ko‘rindi. Endi esa chiziq o‘zgaryapti: foydalanuvchi bir vazifa ichida skrinshot yuboradi, ovoz bilan tushuntiradi, hujjat biriktiradi, video ko‘rsatadi va javobni matn, rasm yoki ovoz shaklida oladi.
Mana shu o‘zgarish multimodal AIMatn, rasm, ovoz, video yoki boshqa signal turlarini birga tushuna oladigan AI yondashuvi. degan mavzuni muhim qiladi. Bu “model rasm ham chiza oladi” degani emas. Asosiy farq shunda: model bir nechta signal turini alohida fayl sifatida emas, bitta vazifa konteksti sifatida ko‘ra boshlaydi.
Multimodal AIMatn, rasm, ovoz, video yoki boshqa signal turlarini birga tushuna oladigan AI yondashuvi. nima?
Multimodal AIMatn, rasm, ovoz, video yoki boshqa signal turlarini birga tushuna oladigan AI yondashuvi. - matn, rasm, ovoz, video yoki boshqa signal turlarini birga tushuna oladigan yoki ular asosida natija yaratadigan AI yondashuvi.
Oddiy matnli modelga faqat yozilgan promptModelga berilgan ko‘rsatma yoki topshiriq matni. Javob sifati ko‘pincha shu kirishga bog‘liq bo‘ladi. beriladi. Multimodal model esa savolga javob berishda quyidagi narsalarni ham hisobga olishi mumkin:
- skrinshotda nima ko‘rinayotgani;
- rasm ichidagi obyekt, matn yoki kompozitsiya;
- video davomida nima o‘zgarayotgani;
- ovozdagi so‘z, pauza yoki tuzatish;
- fayl yoki hujjatdagi strukturali ma’lumot.
Muhim jihat: bular alohida-alohida ishlatilsa ham, haqiqiy qiymat ular bir vazifada bog‘langanda chiqadi. Masalan, foydalanuvchi landing page skrinshotini yuborib, ovoz bilan “shu joyi nega ishonchsiz ko‘rinyapti?” desa, model ham rasmni, ham gapdagi niyatni tushunishi kerak.
ContextModelga shu paytda berilgan foydali ma’lumotlar to‘plami: qoida, hujjat, oldingi xabarlar va vazifa tavsifi. endi faqat matn emas
Oldingi AI ishlarda context ko‘pincha matn edi: qoida, hujjat, chat tarixi, brief yoki promptModelga berilgan ko‘rsatma yoki topshiriq matni. Javob sifati ko‘pincha shu kirishga bog‘liq bo‘ladi.. Multimodal AIMatn, rasm, ovoz, video yoki boshqa signal turlarini birga tushuna oladigan AI yondashuvi.’da contextModelga shu paytda berilgan foydali ma’lumotlar to‘plami: qoida, hujjat, oldingi xabarlar va vazifa tavsifi. kengayadi. Endi kontekstga rasm, video, audio, ekran holati va fayl ham kirishi mumkin.
Bu mahsulot dizaynini o‘zgartiradi. Foydalanuvchi “mana shu rasmni tahlil qil” demaydi, balki “mana shu rasmni ko‘r, kecha aytgan brandMahsulot yoki kompaniyaning nomi, rangi, logosi, ovozi va umumiy ko‘rinishi. AI reklamada brand elementlari izchil saqlanishi kerak. uslubimizga mos keladimi?” deydi. Model uchun muammo faqat rasmni tanish emas; u rasmni oldingi maqsad, brandMahsulot yoki kompaniyaning nomi, rangi, logosi, ovozi va umumiy ko‘rinishi. AI reklamada brand elementlari izchil saqlanishi kerak. talabi va foydalanuvchi niyati bilan bog‘lashi kerak.
Shu sabab multimodal AIMatn, rasm, ovoz, video yoki boshqa signal turlarini birga tushuna oladigan AI yondashuvi.’da promptModelga berilgan ko‘rsatma yoki topshiriq matni. Javob sifati ko‘pincha shu kirishga bog‘liq bo‘ladi. sifati ham boshqacha. “Bu rasmni yaxshila” degan promptModelga berilgan ko‘rsatma yoki topshiriq matni. Javob sifati ko‘pincha shu kirishga bog‘liq bo‘ladi. kamlik qiladi. Yaxshi promptModelga berilgan ko‘rsatma yoki topshiriq matni. Javob sifati ko‘pincha shu kirishga bog‘liq bo‘ladi. modelga qaysi input muhimligini, nimaga e’tibor berishini va natija qanday formatda kerakligini aytadi.
Matn + rasm
Eng tanish multimodal holat - matn va rasm. Foydalanuvchi skrinshot, mahsulot rasmi, diagramma, hujjat fotosi yoki dizayn mockup yuboradi va savol beradi.
Masalan:
Bu pricing section skrinshotini tahlil qil.
E’tibor ber: CTA, narxlar farqi, trust signal, mobil o‘qilishi.
Natija: 5 ta muammo va har biri uchun bitta amaliy fix.
Bu oddiy image captionVideo yoki rasm ustida ko‘rinadigan qisqa matn. Short-form videoda caption uchun kadr ichida oldindan bo‘sh joy qoldiriladi. emas. Model rasmda nima borligini aytib berishdan tashqari, mahsulot maqsadiga qarab baholashi kerak. Shu joyda AI rasm generatsiyasi va rasm tahrirlash mavzulari multimodal ishlashga ulanadi.
Rasm bilan ishlaganda eng katta xato - model ko‘rgan narsani to‘liq tushundi deb o‘ylash. U kichik matnni adashtirishi, diagrammadagi yo‘nalishni noto‘g‘ri o‘qishi yoki rasmda ko‘rinmaydigan narsani taxmin qilishi mumkin. Shuning uchun muhim UI, invoice, shartnoma, tibbiy rasm yoki moliyaviy hujjatda tekshiruv kerak.
Matn + ovoz
Ovoz multimodal AIMatn, rasm, ovoz, video yoki boshqa signal turlarini birga tushuna oladigan AI yondashuvi.’ni chatdan ancha tabiiyroq interfeysga olib chiqadi. Foydalanuvchi promptModelga berilgan ko‘rsatma yoki topshiriq matni. Javob sifati ko‘pincha shu kirishga bog‘liq bo‘ladi. yozmaydi, gapiradi. Lekin Voice AI faqat transcript emas: gapdagi tuzatish, ohang, pauza va “yo‘q, boshqacha aytaman” kabi signal ham muhim.
Masalan:
Mana shu xatni mijozga yuborishdan oldin yumshoqroq qilib ber.
Lekin deadline o‘zgarmasin. Narxni esa hozircha ochiq qoldir.
Bu yerda model matnni qayta yozadi, lekin qaror ovozli vaziyatdan keladi. Agar foydalanuvchi gapini o‘rtada tuzatsa, model oxirgi niyatni olishga harakat qilishi kerak.
Ovozli multimodal tajribada latency juda seziladi. Matnli chatda 5 soniya kutish chidasa bo‘ladi. Ovozli suhbatda esa bu pauza suhbat ritmini buzadi.
Matn + video
Video multimodal AIMatn, rasm, ovoz, video yoki boshqa signal turlarini birga tushuna oladigan AI yondashuvi. uchun qiyinroq qatlam. Chunki model bitta rasmni emas, vaqt davomida o‘zgarayotgan sahnani tushunishi kerak: obyekt qayerga harakatlandi, kamera qanday yurdi, personaj izchil qoldimi, audio mos keldimi, qaysi kadr reklama uchun foydali?
Masalan:
Bu 10 soniyalik product videoni tahlil qil.
Qaysi joyda mahsulot yaxshi ko‘rinmayapti?
Qaysi kadrni thumbnail qilish mumkin?
Audio va harakat bir-biriga mosmi?
Bu savol AI video generatsiyasi maqolasidagi model tanlashdan farq qiladi. Bu yerda video yaratish emas, videoni tushunish va undan qaror chiqarish muhim. Lekin ikkala yo‘nalish bir-biriga bog‘liq: video yaratadigan model ham sahna, kadr, audio va harakatni tushunishi kerak.
Bitta modelmi yoki ketma-ketlikmi?
Mahsulot foydalanuvchiga “bitta multimodal assistant” bo‘lib ko‘rinishi mumkin. Lekin ichkarida har doim bitta model ishlayapti deb bo‘lmaydi.
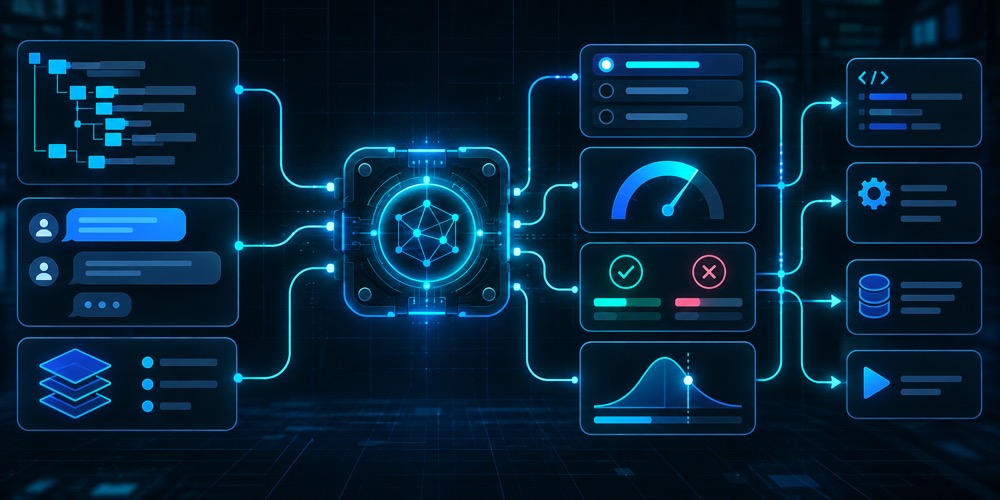
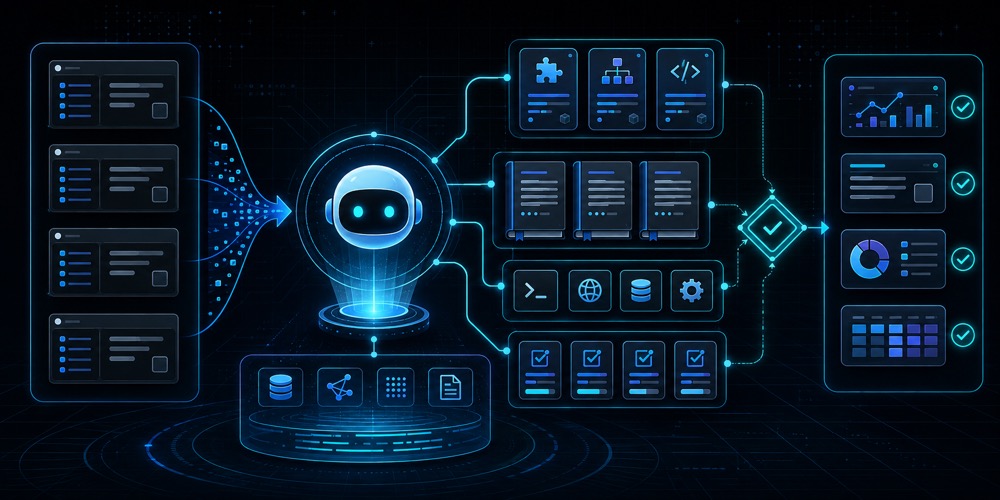
Ba’zi tizimlarda ketma-ketlik shunday bo‘ladi:
- speech-to-textOvozli nutqni yozma matnga aylantirish jarayoni. Voice AI va diktovka vositalarining kirish qatlami. ovozni matnga aylantiradi;
- vision model rasm yoki skrinshotni tushunadi;
- LLMLarge Language Model qisqartmasi. Katta matn korpuslarida o‘qitilgan va til bilan ishlaydigan model turi. javobni rejalaydi;
- image yoki video model natija yaratadi;
- text-to-speechMatnni tabiiy eshitiladigan ovozga aylantirish jarayoni. Ovozli yordamchi javobini eshittirish uchun ishlatiladi. javobni ovozga aylantiradi.
Foydalanuvchi uchun bu bitta tajriba. Developer uchun esa bu bir nechta model, format, latencySo‘rov yuborilgandan foydalanuvchi natija ko‘rguncha o‘tadigan kechikish vaqti. va xato manbasi degani. Bir bosqichdagi xato keyingi bosqichga o‘tadi. Masalan, audio noto‘g‘ri transcribe qilinsa, LLMLarge Language Model qisqartmasi. Katta matn korpuslarida o‘qitilgan va til bilan ishlaydigan model turi. to‘g‘ri javob bera olmaydi. Rasm noto‘g‘ri captionVideo yoki rasm ustida ko‘rinadigan qisqa matn. Short-form videoda caption uchun kadr ichida oldindan bo‘sh joy qoldiriladi. qilinsa, tahrir ham noto‘g‘ri ketadi.
Qayerda foydali?
Dizayn va marketing
Skrinshot, brandMahsulot yoki kompaniyaning nomi, rangi, logosi, ovozi va umumiy ko‘rinishi. AI reklamada brand elementlari izchil saqlanishi kerak. reference, mahsulot rasmi va brief bitta vazifada ishlaydi. Masalan, AI banner draftini ko‘rib, “brandMahsulot yoki kompaniyaning nomi, rangi, logosi, ovozi va umumiy ko‘rinishi. AI reklamada brand elementlari izchil saqlanishi kerak. rangimizga mosmi, matn o‘qilyaptimi, CTACall to action qisqartmasi. Video yoki sahifa oxirida foydalanuvchidan kutilgan keyingi amal: bosish, yozilish yoki sotib olish. ko‘rinadimi?” deb baholaydi.
Ta’lim
O‘quvchi masala rasmini yuboradi, ovoz bilan qayerda tushunmaganini aytadi, model esa qadam-baqadam izoh beradi. Bu faqat OCR emas, o‘quvchining savolini ham tushunishdir.
Support
Mijoz skrinshot yoki qisqa video yuboradi. AI xatoni ko‘rib, support javobini tayyorlaydi yoki muammoni to‘g‘ri bo‘limga yo‘naltiradi.
E-commerce
Mahsulot rasmi, tavsif, video reklama, captionVideo yoki rasm ustida ko‘rinadigan qisqa matn. Short-form videoda caption uchun kadr ichida oldindan bo‘sh joy qoldiriladi. va platforma formati bir ish jarayonida bog‘lanadi. Ecommerce reklama videolarida bu ayniqsa seziladi: mahsulot ko‘rinishi, audio, CTACall to action qisqartmasi. Video yoki sahifa oxirida foydalanuvchidan kutilgan keyingi amal: bosish, yozilish yoki sotib olish. va safe areaMobil video yoki dizaynda muhim yuz, product, logo va matn platforma tugmalari yoki caption bilan yopilmaydigan xavfsiz hudud. bitta qarorga aylanadi.
Kod va UI debugging
Developer error skrinshoti, terminal logi, repo konteksti va nima qilmoqchi ekanini birga beradi. Model “bu xatoni o‘qib berish”dan ko‘ra, vaziyatni bog‘lab tahlil qiladi.
Nega qiyin?
Multimodal AIMatn, rasm, ovoz, video yoki boshqa signal turlarini birga tushuna oladigan AI yondashuvi. kuchli ko‘rinadi, lekin xato yuzasi ham kengroq.
Rasm noto‘g‘ri tushunilishi mumkin. Video ichida vaqt va harakat adashishi mumkin. Ovoz transcripti xato bo‘lishi mumkin. Fayl ichidagi jadval noto‘g‘ri parse qilinishi mumkin. Eng yomoni, model bir modality’dagi noaniq signalni boshqa modality bilan “to‘ldirib”, ishonchli lekin noto‘g‘ri javob chiqarishi mumkin.
Bu hallucination muammosini yo‘qotmaydi, balki boshqa shaklga olib keladi. Shu sabab multimodal tizimlarda tekshiruv, manba, citationAI javobida qaysi hujjat, sahifa yoki bo‘limga tayanganini ko‘rsatadigan manba havolasi yoki izoh., confidence va foydalanuvchi tasdig‘i muhim.
Yana bir masala - maxfiylik. Rasm va audio matndan ko‘ra ko‘proq shaxsiy signal olib yuradi. Skrinshotda email, mijoz ismi, narx, tokenModel matnni ichkarida qayta ishlash uchun bo‘ladigan kichik birlik. Narx va limitlar ko‘pincha token bilan o‘lchanadi., APIDasturlar bir-biri bilan gaplashishi uchun ishlatiladigan interfeys. AI mahsulotlarda model, servis yoki tool shu yo‘l bilan chaqiriladi. key yoki ichki dashboard ko‘rinib qolishi mumkin. Bu PII va maxfiy ma’lumotlar mavzusiga bevosita ulanadi.
Multimodal promptModelga berilgan ko‘rsatma yoki topshiriq matni. Javob sifati ko‘pincha shu kirishga bog‘liq bo‘ladi. qanday yoziladi?
Yaxshi multimodal promptModelga berilgan ko‘rsatma yoki topshiriq matni. Javob sifati ko‘pincha shu kirishga bog‘liq bo‘ladi. uch narsani aniqlaydi:
- qaysi input muhim;
- model nimaga e’tibor berishi kerak;
- natija qanday formatda kerak.
Masalan:
Bu landing page skrinshotini tahlil qil.
Faqat birinchi ekran bo‘yicha fikr ber.
E’tibor ber: headline, CTA, trust signal, mobil o‘qilishi.
Natija: jadval formatida 5 muammo, har biriga severity va fix.
Video uchun:
Bu 12 soniyalik reklama videoni ko‘r.
Maqsad: product demo sifatini baholash.
E’tibor ber: mahsulot ko‘rinishi, kamera, audio, final frame.
Natija: saqlash kerak bo‘lgan 3 joy va qayta generatsiya qilish kerak bo‘lgan 3 joy.
Ovoz uchun:
Men aytgan fikrlarni email qoralamasiga aylantir.
Oxirgi tuzatishlarimni ustun deb ol.
Ohang: iliq, lekin aniq.
Natija: yuborishga tayyor email.
Mahsulot tanlashda nimaga qarash kerak?
Multimodal AIMatn, rasm, ovoz, video yoki boshqa signal turlarini birga tushuna oladigan AI yondashuvi. mahsulot tanlashda “rasm ham oladimi?” degan savol yetmaydi. Quyidagilar muhimroq:
- qaysi input turlarini qabul qiladi;
- rasm/video/ovozni haqiqatan tushunadimi yoki faqat transcript/captionVideo yoki rasm ustida ko‘rinadigan qisqa matn. Short-form videoda caption uchun kadr ichida oldindan bo‘sh joy qoldiriladi. qiladimi;
- javob tezligi qanday;
- fayl va media maxfiyligi qanday;
- tahrir imkoniyati bormi;
- APIDasturlar bir-biri bilan gaplashishi uchun ishlatiladigan interfeys. AI mahsulotlarda model, servis yoki tool shu yo‘l bilan chaqiriladi. orqali ulash mumkinmi;
- narx matn, rasm, audio va video bo‘yicha qanday hisoblanadi;
- natijani tekshirish uchun source yoki intermediate output bormi.
Bu yerda AI billingdagi yashirin xarajatlar ham dolzarb. Multimodal tizimda tokenModel matnni ichkarida qayta ishlash uchun bo‘ladigan kichik birlik. Narx va limitlar ko‘pincha token bilan o‘lchanadi. bilan birga rasm, video, audio processing va storage xarajati ham kiradi.
Xulosa
Multimodal AIMatn, rasm, ovoz, video yoki boshqa signal turlarini birga tushuna oladigan AI yondashuvi. modelni shunchaki “ko‘proq narsa qila oladigan chat”ga aylantirmaydi. U AI bilan ishlash uslubini o‘zgartiradi: foydalanuvchi vazifani matn, rasm, video va ovoz bilan tushuntiradi, model esa ularni bitta kontekstga yig‘ib qaror chiqaradi.
Eng katta foyda shu: AI endi odam ishlayotgan real materialga yaqinlashadi. Eng katta xavf ham shu: model ko‘proq narsani ko‘radi, demak xato, maxfiylik, latencySo‘rov yuborilgandan foydalanuvchi natija ko‘rguncha o‘tadigan kechikish vaqti. va narxni ham jiddiyroq boshqarish kerak.