RAGRetrieval-Augmented Generation qisqartmasi. Model javob berishdan oldin tashqi manbadan kerakli ma’lumot olib keladi. chatbotAsosan savol-javob shaklida ishlaydigan suhbat interfeysi. U doim ham agent darajasida harakat qilmaydi. qurishni darrov web app, Telegram bot yoki support widgetdan boshlash shart emas. Aksincha, birinchi versiyani terminalda ishlatish ko‘pincha tozaroq: hujjat qanday bo‘linyapti, qidiruv qaysi chunk’larni topyapti, model qaysi contextModelga shu paytda berilgan foydali ma’lumotlar to‘plami: qoida, hujjat, oldingi xabarlar va vazifa tavsifi. asosida javob beryapti - hammasi ko‘zga ko‘rinadi.
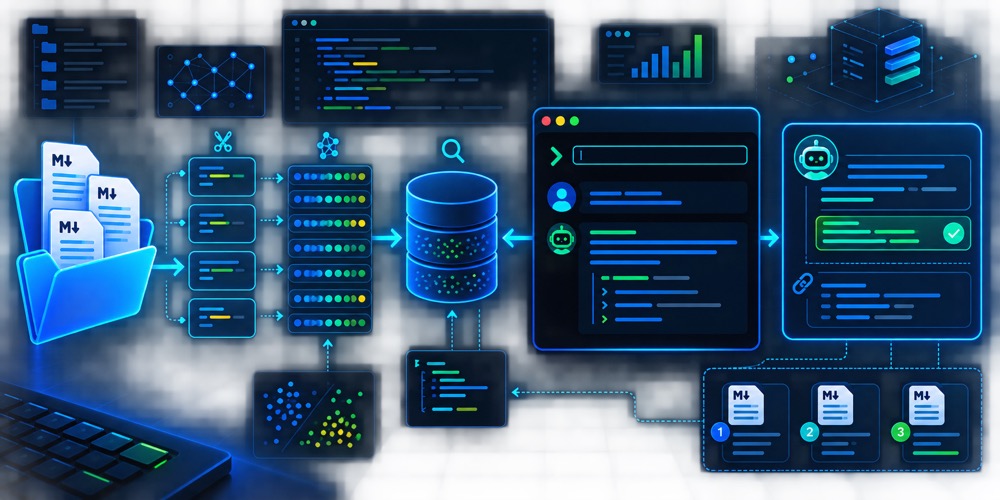
Bu tutorialda minimal CLICommand line interface. Dastur bilan terminal orqali buyruq yozib ishlash usuli. RAGRetrieval-Augmented Generation qisqartmasi. Model javob berishdan oldin tashqi manbadan kerakli ma’lumot olib keladi. chatbotAsosan savol-javob shaklida ishlaydigan suhbat interfeysi. U doim ham agent darajasida harakat qilmaydi. qilamiz. U docs/ papkasidagi .md va .txt fayllarni o‘qiydi, ularni chunk’larga bo‘ladi, OpenAI embeddingMatnni ma’nosiga yaqin sonli vektorga aylantirish usuli. Ko‘pincha semantik qidiruv va RAG’da ishlatiladi. modeli bilan vektorga aylantiradi, lokal data/index.json faylga yozadi va terminaldan berilgan savolga manbalar bilan javob qaytaradi.
Bu production arxitektura emas. Maqsad - RAGRetrieval-Augmented Generation qisqartmasi. Model javob berishdan oldin tashqi manbadan kerakli ma’lumot olib keladi. oqimini tushunish. Keyin shu mantiqni PostgreSQL + pgvector, Supabase Vector, Qdrant, Pinecone yoki boshqa vector databasega ko‘chirish mumkin.
Nima quramiz?
Flow shunday bo‘ladi:
docs/*.md
  -> text extraction
  -> chunking
  -> embeddings
  -> local JSON index
  -> CLI question
  -> query embedding
  -> cosine search
  -> prompt with retrieved context
  -> answer + sources
Bu klassik RAG oqimi: model javob yozishdan oldin tashqi bilim bazadan kerakli bo‘laklarni topadi. Farqi shuki, biz hozir vector databaseEmbedding ko‘rinishidagi vektorlarni saqlash va yaqin ma’nodagi yozuvlarni topish uchun mo‘ljallangan baza turi. o‘rniga oddiy JSON fayldan foydalanamiz. Kichik tutorial uchun bu yetarli.
Talablar
Sizga quyidagilar kerak bo‘ladi:
- Node.js 20 yoki undan yuqori versiya;
- OpenAI APIDasturlar bir-biri bilan gaplashishi uchun ishlatiladigan interfeys. AI mahsulotlarda model, servis yoki tool shu yo‘l bilan chaqiriladi. key;
- bir nechta
.mdyoki.txthujjat; - terminalda ishlash uchun oddiy loyiha papkasi.
OpenAI Node SDK bo‘yicha rasmiy yo‘l openai paketini o‘rnatish va OPENAI_APIDasturlar bir-biri bilan gaplashishi uchun ishlatiladigan interfeys. AI mahsulotlarda model, servis yoki tool shu yo‘l bilan chaqiriladi._KEY environment variable orqali client yaratishdir. EmbeddingMatnni ma’nosiga yaqin sonli vektorga aylantirish usuli. Ko‘pincha semantik qidiruv va RAG’da ishlatiladi. uchun client.embeddings.create(...), javob generatsiyasi uchun esa Responses APIDasturlar bir-biri bilan gaplashishi uchun ishlatiladigan interfeys. AI mahsulotlarda model, servis yoki tool shu yo‘l bilan chaqiriladi. ishlatamiz. Rasmiy boshlang‘ich docs: OpenAI API quickstart va openai-node.
Loyiha strukturasi
rag-cli/
  docs/
    pricing.md
    refund.md
    onboarding.md
  src/
    chunk.js
    embed.js
    ingest.js
    search.js
    ask.js
  data/
    index.json
  .env
  package.json
docs/ ichida bilim bazasi turadi. src/ingest.js hujjatlarni index qiladi. src/ask.js terminaldan savol olib, javob beradi.
Loyiha yaratish
mkdir rag-cli
cd rag-cli
npm init -y
npm install openai dotenv
mkdir -p docs src data
package.json ichida ESM va scriptlarni qo‘shing:
{
  "type": "module",
  "scripts": {
    "ingest": "node src/ingest.js",
    "ask": "node src/ask.js"
  },
  "dependencies": {
    "dotenv": "latest",
    "openai": "latest"
  }
}
.env:
OPENAI_API_KEY=sk-...
CHAT_MODEL=gpt-5.5
EMBEDDING_MODEL=text-embedding-3-small
CHAT_MODELni o‘zingiz ishlatayotgan modelga almashtirishingiz mumkin. text-embeddingMatnni ma’nosiga yaqin sonli vektorga aylantirish usuli. Ko‘pincha semantik qidiruv va RAG’da ishlatiladi.-3-small kichik RAGRetrieval-Augmented Generation qisqartmasi. Model javob berishdan oldin tashqi manbadan kerakli ma’lumot olib keladi. tutorial uchun yaxshi boshlang‘ich tanlov: arzonroq, tezroq va semantic searchSo‘z aynan bir xil bo‘lishini emas, ma’no yaqinligini topishga qaratilgan qidiruv usuli. uchun yetarli. Katta, ko‘p tilli yoki nozik retrieval talabi bo‘lsa, embeddingMatnni ma’nosiga yaqin sonli vektorga aylantirish usuli. Ko‘pincha semantik qidiruv va RAG’da ishlatiladi. model tanlovini alohida test qilish kerak.
Demo hujjatlar
docs/pricing.md:
# Pricing

Starter tarif oyiga $19. Kichik jamoalar uchun mos.
Pro tarif oyiga $49. Unda priority support va ko‘proq usage limit bor.
Enterprise tarif custom narxlanadi va SSO, audit log hamda dedicated support beradi.
docs/refund.md:
# Refund policy

Foydalanuvchi xariddan keyin 14 kun ichida refund so‘rashi mumkin.
Refund faqat hisobda jiddiy foydalanish bo‘lmagan holatda beriladi.
Enterprise shartnomalarida refund alohida kelishuvga bog‘liq.
docs/onboarding.md:
# Onboarding

Yangi mijoz avval account yaratadi, keyin billing sozlaydi.
Jamoa a’zolari Settings bo‘limidan taklif qilinadi.
SSO faqat Enterprise tarifda yoqiladi.
Haqiqiy loyihada hujjatlar bundan kattaroq bo‘ladi. Lekin RAGRetrieval-Augmented Generation qisqartmasi. Model javob berishdan oldin tashqi manbadan kerakli ma’lumot olib keladi. sifatini tushunishda kichik, aniq hujjatlar bilan boshlash foydali: agar mini datasetda retrieval ishlamasa, katta datasetda ham barqaror bo‘lmaydi.
OpenAI client
src/embed.js:
import "dotenv/config";
import OpenAI from "openai";

const client = new OpenAI();

export async function embedText(text) {
  const response = await client.embeddings.create({
    model: process.env.EMBEDDING_MODEL ?? "text-embedding-3-small",
    input: text,
    encoding_format: "float"
  });

  return response.data[0].embedding;
}

export async function answerWithContext({ question, context }) {
  const response = await client.responses.create({
    model: process.env.CHAT_MODEL ?? "gpt-5.5",
    instructions: [
      "Siz bilim bazasi yordamchisisiz.",
      "Faqat berilgan context asosida javob bering.",
      "Agar javob context ichida bo‘lmasa, bilmayman deb ayting.",
      "Javobni qisqa, aniq va foydalanuvchi tilida yozing."
    ].join("\n"),
    input: [
      {
        role: "user",
        content: [
          {
            type: "input_text",
            text: `Context:\n${context}\n\nSavol:\n${question}`
          }
        ]
      }
    ]
  });

  return response.output_text;
}
Bu yerda encoding_format: "float" qo‘ydik, chunki embeddingMatnni ma’nosiga yaqin sonli vektorga aylantirish usuli. Ko‘pincha semantik qidiruv va RAG’da ishlatiladi. vektorlarini oddiy JavaScript array sifatida ishlatamiz. SDK ichida boshqa optimizatsiyalar bo‘lishi mumkin, lekin tutorialda cosine similarityIkki vektor yo‘nalishi qanchalik o‘xshashligini o‘lchaydigan usul. Semantik qidiruvda savol va chunk yaqinligini baholash uchun ishlatiladi. hisoblash uchun float array tushunarliroq.
ChunkingKatta hujjatni qidiruv va model contextiga qulay kichik bo‘laklarga ajratish jarayoni.
RAGRetrieval-Augmented Generation qisqartmasi. Model javob berishdan oldin tashqi manbadan kerakli ma’lumot olib keladi. sifati ko‘pincha modeldan oldin chunkingKatta hujjatni qidiruv va model contextiga qulay kichik bo‘laklarga ajratish jarayoni.’da buziladi. Juda katta chunk umumiy bo‘lib ketadi, juda kichik chunk esa ma’noni yo‘qotadi. Biz hozir sodda yondashuv qilamiz: hujjatni paragraflar bo‘yicha yig‘ib, taxminan 1200 belgidan oshsa yangi chunk boshlaymiz.
src/chunk.js:
export function chunkText({ source, text, maxChars = 1200 }) {
  const blocks = text
    .split(/\n\s*\n/g)
    .map((block) => block.trim())
    .filter(Boolean);

  const chunks = [];
  let current = "";

  for (const block of blocks) {
    const next = current ? `${current}\n\n${block}` : block;

    if (next.length > maxChars && current) {
      chunks.push(current);
      current = block;
    } else {
      current = next;
    }
  }

  if (current) chunks.push(current);

  return chunks.map((chunk, index) => ({
    id: `${source}#${index + 1}`,
    source,
    index,
    text: chunk
  }));
}
Bu ideal chunkingKatta hujjatni qidiruv va model contextiga qulay kichik bo‘laklarga ajratish jarayoni. emas, lekin boshlash uchun yetarli. Keyin heading, overlap, metadata, section title va file path kabi qo‘shimchalar kiritiladi. Batafsil tushuncha uchun embedding va qidiruv maqolasidagi chunkingKatta hujjatni qidiruv va model contextiga qulay kichik bo‘laklarga ajratish jarayoni. bo‘limiga qaytish mumkin.
Ingestion: hujjatlarni index qilish
src/ingest.js:
import fs from "node:fs/promises";
import path from "node:path";
import { chunkText } from "./chunk.js";
import { embedText } from "./embed.js";

const docsDir = path.join(process.cwd(), "docs");
const indexPath = path.join(process.cwd(), "data", "index.json");

async function readDocs() {
  const files = await fs.readdir(docsDir);
  const docs = [];

  for (const file of files) {
    if (!file.endsWith(".md") && !file.endsWith(".txt")) continue;

    const fullPath = path.join(docsDir, file);
    const text = await fs.readFile(fullPath, "utf8");
    docs.push({ source: file, text });
  }

  return docs;
}

async function main() {
  const docs = await readDocs();
  const chunks = docs.flatMap((doc) => chunkText(doc));

  const indexed = [];

  for (const chunk of chunks) {
    const embedding = await embedText(chunk.text);
    indexed.push({ ...chunk, embedding });
    console.log(`indexed ${chunk.id}`);
  }

  await fs.mkdir(path.dirname(indexPath), { recursive: true });
  await fs.writeFile(indexPath, JSON.stringify(indexed, null, 2));

  console.log(`saved ${indexed.length} chunks to ${indexPath}`);
}

main().catch((error) => {
  console.error(error);
  process.exit(1);
});
Ishga tushirish:
npm run ingest
Natijada data/index.json ichida har bir chunk, source va embeddingMatnni ma’nosiga yaqin sonli vektorga aylantirish usuli. Ko‘pincha semantik qidiruv va RAG’da ishlatiladi. saqlanadi. Har safar hujjat o‘zgarsa, indexni qayta yaratish kerak. Production’da buni incremental qilish, file hash saqlash va faqat o‘zgargan hujjatlarni qayta embeddingMatnni ma’nosiga yaqin sonli vektorga aylantirish usuli. Ko‘pincha semantik qidiruv va RAG’da ishlatiladi. qilish yaxshiroq.
Search: savolga yaqin chunk’larni topish
src/search.js:
export function cosineSimilarity(a, b) {
  let dot = 0;
  let normA = 0;
  let normB = 0;

  for (let i = 0; i < a.length; i += 1) {
    dot += a[i] * b[i];
    normA += a[i] * a[i];
    normB += b[i] * b[i];
  }

  if (!normA || !normB) return 0;
  return dot / (Math.sqrt(normA) * Math.sqrt(normB));
}

export function searchChunks({ queryEmbedding, chunks, topK = 4 }) {
  return chunks
    .map((chunk) => ({
      ...chunk,
      score: cosineSimilarity(queryEmbedding, chunk.embedding)
    }))
    .sort((a, b) => b.score - a.score)
    .slice(0, topK);
}
Katta datasetda bunday linear scan sekin bo‘ladi. 100-500 chunk uchun tutorialda yetadi. Minglab yoki millionlab chunk bo‘lsa, approximate nearest neighbor qidiruv beradigan vector databaseEmbedding ko‘rinishidagi vektorlarni saqlash va yaqin ma’nodagi yozuvlarni topish uchun mo‘ljallangan baza turi. kerak bo‘ladi.
CLICommand line interface. Dastur bilan terminal orqali buyruq yozib ishlash usuli. ask: savol berish
src/ask.js:
import fs from "node:fs/promises";
import path from "node:path";
import { answerWithContext, embedText } from "./embed.js";
import { searchChunks } from "./search.js";

const question = process.argv.slice(2).join(" ").trim();

if (!question) {
  console.error('Usage: npm run ask -- "Refund siyosati qanday?"');
  process.exit(1);
}

const indexPath = path.join(process.cwd(), "data", "index.json");

function buildContext(chunks) {
  return chunks
    .map((chunk, index) => {
      return [
        `[${index + 1}] Source: ${chunk.source}`,
        `Score: ${chunk.score.toFixed(3)}`,
        chunk.text
      ].join("\n");
    })
    .join("\n\n---\n\n");
}

async function main() {
  const raw = await fs.readFile(indexPath, "utf8");
  const chunks = JSON.parse(raw);

  const queryEmbedding = await embedText(question);
  const matches = searchChunks({ queryEmbedding, chunks, topK: 4 });
  const context = buildContext(matches);

  const answer = await answerWithContext({ question, context });

  console.log("\nJavob:\n");
  console.log(answer);

  console.log("\nManbalar:\n");
  for (const match of matches) {
    console.log(`- ${match.source} (${match.score.toFixed(3)})`);
  }
}

main().catch((error) => {
  console.error(error);
  process.exit(1);
});
Ishga tushirish:
npm run ask -- "Refund siyosati qanday?"
Kutiladigan natija:
Javob:

Refund xariddan keyin 14 kun ichida so‘ralishi mumkin. Lekin hisobda jiddiy foydalanish bo‘lmagan bo‘lishi kerak. Enterprise shartnomalarida refund alohida kelishuvga bog‘liq.

Manbalar:
- refund.md (0.842)
- pricing.md (0.611)
- onboarding.md (0.588)
Bu yerda manbalar modelning o‘zi “o‘ylab topgan” citationAI javobida qaysi hujjat, sahifa yoki bo‘limga tayanganini ko‘rsatadigan manba havolasi yoki izoh. emas. Biz retrieval bosqichida topilgan chunk source’larini alohida chiqarib beryapmiz. Real mahsulotda citationAI javobida qaysi hujjat, sahifa yoki bo‘limga tayanganini ko‘rsatadigan manba havolasi yoki izoh. har bir jumla yoki paragraph bilan aniqroq bog‘lanishi kerak.
“Bilmayman” holatini tekshirish
RAGRetrieval-Augmented Generation qisqartmasi. Model javob berishdan oldin tashqi manbadan kerakli ma’lumot olib keladi. chatbotning eng muhim testi to‘g‘ri javobdan ko‘ra “bilmayman” holatidir. Masalan:
npm run ask -- "Kompaniya Toshkentda ofis ochganmi?"
Agar docs ichida bu haqida ma’lumot bo‘lmasa, model taxmin qilmasligi kerak. Promptdagi “faqat contextModelga shu paytda berilgan foydali ma’lumotlar to‘plami: qoida, hujjat, oldingi xabarlar va vazifa tavsifi. asosida javob bering” qoidasi shu uchun. Lekin faqat promptga ishonib qolmang. Hallucination baribir tekshirilishi kerak.
Amaliy himoya: agar topilgan chunk’larning eng yuqori score’i juda past bo‘lsa, modelni umuman chaqirmasdan “bilim bazasida bu savolga yetarli ma’lumot topilmadi” deb qaytarish mumkin.
src/ask.js ichida model chaqirishdan oldin:
if (matches[0]?.score < 0.72) {
  console.log("Bilim bazasida bu savolga yetarli ma’lumot topilmadi.");
  process.exit(0);
}
Bu threshold universal emas. Uni o‘z dataset va savollaringizda test qilish kerak.
EvalAI javobi qanchalik to‘g‘ri, foydali yoki barqaror ekanini oldindan belgilangan mezonlar bilan baholash jarayoni. fayl qo‘shish
RAGRetrieval-Augmented Generation qisqartmasi. Model javob berishdan oldin tashqi manbadan kerakli ma’lumot olib keladi. tizimni “men sinab ko‘rdim, ishlayapti” bilan baholash yetarli emas. Kichik evalAI javobi qanchalik to‘g‘ri, foydali yoki barqaror ekanini oldindan belgilangan mezonlar bilan baholash jarayoni./questions.json fayldan boshlash mumkin:
[
  {
    "question": "Refund necha kun ichida so‘raladi?",
    "expectedSource": "refund.md"
  },
  {
    "question": "SSO qaysi tarifda bor?",
    "expectedSource": "onboarding.md"
  },
  {
    "question": "Pro tarifda nima bor?",
    "expectedSource": "pricing.md"
  }
]
Minimal evalAI javobi qanchalik to‘g‘ri, foydali yoki barqaror ekanini oldindan belgilangan mezonlar bilan baholash jarayoni. script topilgan birinchi source kutilgan source bilan mos keladimi, shuni tekshirishi mumkin. Keyin javob sifati, citationAI javobida qaysi hujjat, sahifa yoki bo‘limga tayanganini ko‘rsatadigan manba havolasi yoki izoh. aniqligi, “bilmayman” holati va noto‘g‘ri confident javoblar alohida baholanadi. RAGRetrieval-Augmented Generation qisqartmasi. Model javob berishdan oldin tashqi manbadan kerakli ma’lumot olib keladi. uchun eval retrieval va generation’ni alohida o‘lchashi kerak.
Nega reranking qo‘shmadik?
Minimal tutorialda semantic searchSo‘z aynan bir xil bo‘lishini emas, ma’no yaqinligini topishga qaratilgan qidiruv usuli. yetarli. Lekin real knowledge baseKompaniya yoki mahsulot haqidagi tartiblangan ichki bilimlar to‘plami: FAQ, qo‘llanma, siyosat, wiki va dokumentatsiya. kattalashganda top-kQidiruvda eng yuqori ball olgan k ta natijani tanlash usuli. RAG’da modelga nechta chunk berilishini boshqaradi. ichida o‘rtacha chunklar ko‘payadi. Shunda reranking kerak bo‘lishi mumkin: avval embeddingMatnni ma’nosiga yaqin sonli vektorga aylantirish usuli. Ko‘pincha semantik qidiruv va RAG’da ishlatiladi. bilan 20-50 ta nomzod topiladi, keyin alohida ranking modeli yoki LLMLarge Language Model qisqartmasi. Katta matn korpuslarida o‘qitilgan va til bilan ishlaydigan model turi. eng foydali 3-5 tasini tanlaydi.
Reranking qo‘shishdan oldin uch narsani tekshiring:
- chunkingKatta hujjatni qidiruv va model contextiga qulay kichik bo‘laklarga ajratish jarayoni. yomon emasmi;
- metadata yetarlimi;
- query juda noaniq emasmi.
Ko‘p muammo reranking yo‘qligidan emas, yomon hujjat va noto‘g‘ri chunkingKatta hujjatni qidiruv va model contextiga qulay kichik bo‘laklarga ajratish jarayoni.’dan chiqadi.
Productionga olib chiqishda nimalar o‘zgaradi?
Bu CLICommand line interface. Dastur bilan terminal orqali buyruq yozib ishlash usuli. demo yaxshi boshlanish, lekin production uchun yetarli emas.
Avvalo JSON index o‘rniga haqiqiy vector databaseEmbedding ko‘rinishidagi vektorlarni saqlash va yaqin ma’nodagi yozuvlarni topish uchun mo‘ljallangan baza turi. ishlatiladi. Chunk’lar bilan birga metadata saqlanadi: document ID, section title, version, language, access level, last updated. Aks holda foydalanuvchi ko‘rmasligi kerak bo‘lgan hujjat javobga kirib qolishi mumkin.
Ikkinchi muammo - yangilanish. Hujjat o‘zgarganda eski embeddingMatnni ma’nosiga yaqin sonli vektorga aylantirish usuli. Ko‘pincha semantik qidiruv va RAG’da ishlatiladi. qolib ketmasligi kerak. Buning uchun file hash, document version va re-index queue kerak bo‘ladi.
Uchinchi muammo - kuzatuvchanlik. Har savolda query, top-kQidiruvda eng yuqori ball olgan k ta natijani tanlash usuli. RAG’da modelga nechta chunk berilishini boshqaradi. chunks, score, model javobi va user feedback saqlansa, qaysi joyda tizim buzilayotganini topish osonlashadi. Bu AI mahsulotni tekshirish jarayonining bir qismi.
Eng ko‘p uchraydigan xatolar
Chunk juda katta
Modelga topilgan chunk mos ko‘rinadi, lekin ichida juda ko‘p ortiqcha matn bo‘ladi. Javob umumiylashadi yoki noto‘g‘ri joyga tayanadi.
Chunk juda kichik
Relevant jumla topiladi, lekin qoida yoki kontekstning ikkinchi yarmi boshqa chunk’da qoladi. Javob yarim chiqadi.
Source metadata yo‘q
Javob yaxshi bo‘lsa ham, foydalanuvchi manbani tekshira olmaydi. RAGRetrieval-Augmented Generation qisqartmasi. Model javob berishdan oldin tashqi manbadan kerakli ma’lumot olib keladi.’ning asosiy foydalaridan biri yo‘qoladi.
PromptModelga berilgan ko‘rsatma yoki topshiriq matni. Javob sifati ko‘pincha shu kirishga bog‘liq bo‘ladi. modelga haddan tashqari erkinlik beradi
“Foydali javob ber” deyish yetmaydi. “Faqat contextModelga shu paytda berilgan foydali ma’lumotlar to‘plami: qoida, hujjat, oldingi xabarlar va vazifa tavsifi. asosida javob ber, yo‘q bo‘lsa bilmayman de” kabi guardrail kerak.
EvalAI javobi qanchalik to‘g‘ri, foydali yoki barqaror ekanini oldindan belgilangan mezonlar bilan baholash jarayoni. yo‘q
Bugun yaxshi ishlagan chatbotAsosan savol-javob shaklida ishlaydigan suhbat interfeysi. U doim ham agent darajasida harakat qilmaydi. ertaga hujjat yangilanganda buzilishi mumkin. EvalAI javobi qanchalik to‘g‘ri, foydali yoki barqaror ekanini oldindan belgilangan mezonlar bilan baholash jarayoni. bo‘lmasa, buni foydalanuvchi shikoyat qilgandan keyin bilasiz.
Keyingi qadam
CLICommand line interface. Dastur bilan terminal orqali buyruq yozib ishlash usuli. RAGRetrieval-Augmented Generation qisqartmasi. Model javob berishdan oldin tashqi manbadan kerakli ma’lumot olib keladi. ishlagandan keyin uch yo‘l bor.
Birinchisi - storage’ni almashtirish. JSON index o‘rniga pgvector yoki boshqa vector databaseEmbedding ko‘rinishidagi vektorlarni saqlash va yaqin ma’nodagi yozuvlarni topish uchun mo‘ljallangan baza turi. qo‘shiladi.
Ikkinchisi - UI qo‘shish. Shu ask logikasini Next.js APIDasturlar bir-biri bilan gaplashishi uchun ishlatiladigan interfeys. AI mahsulotlarda model, servis yoki tool shu yo‘l bilan chaqiriladi. route, Telegram bot yoki Slack bot ichiga ulash mumkin.
Uchinchisi - sifatni yaxshilash. Better chunkingKatta hujjatni qidiruv va model contextiga qulay kichik bo‘laklarga ajratish jarayoni., reranking, citationAI javobida qaysi hujjat, sahifa yoki bo‘limga tayanganini ko‘rsatadigan manba havolasi yoki izoh. mapping, feedback logging va evalAI javobi qanchalik to‘g‘ri, foydali yoki barqaror ekanini oldindan belgilangan mezonlar bilan baholash jarayoni. jarayoni qo‘shiladi.
Muhimi, UI’dan oldin retrieval sifatini ko‘rish. Terminaldagi kichik RAGRetrieval-Augmented Generation qisqartmasi. Model javob berishdan oldin tashqi manbadan kerakli ma’lumot olib keladi. chatbotAsosan savol-javob shaklida ishlaydigan suhbat interfeysi. U doim ham agent darajasida harakat qilmaydi. shuni majbur qiladi: modeldan oldin hujjat, chunk, qidiruv va contextModelga shu paytda berilgan foydali ma’lumotlar to‘plami: qoida, hujjat, oldingi xabarlar va vazifa tavsifi. ishlayaptimi - avval shu savolga javob topiladi.
Xulosa
CLICommand line interface. Dastur bilan terminal orqali buyruq yozib ishlash usuli.’da RAGRetrieval-Augmented Generation qisqartmasi. Model javob berishdan oldin tashqi manbadan kerakli ma’lumot olib keladi. chatbotAsosan savol-javob shaklida ishlaydigan suhbat interfeysi. U doim ham agent darajasida harakat qilmaydi. qurish kichik ko‘rinsa ham, developer uchun eng foydali boshlang‘ich mashq. U web dizayn, auth, hosting va bot integratsiyadan chalg‘itmaydi. Siz to‘g‘ridan-to‘g‘ri RAGRetrieval-Augmented Generation qisqartmasi. Model javob berishdan oldin tashqi manbadan kerakli ma’lumot olib keladi.’ning yuragini ko‘rasiz: hujjat qanday bo‘linadi, embeddingMatnni ma’nosiga yaqin sonli vektorga aylantirish usuli. Ko‘pincha semantik qidiruv va RAG’da ishlatiladi. qanday ishlaydi, qidiruv nima topadi, model qaysi contextga tayanadi.
Bilim bazali chatbotni model emas, retrieval sifati yutadi. Model faqat berilgan contextdan foydali javob yasaydi. Agar contextModelga shu paytda berilgan foydali ma’lumotlar to‘plami: qoida, hujjat, oldingi xabarlar va vazifa tavsifi. noto‘g‘ri bo‘lsa, eng kuchli model ham ishonchli mahsulot bermaydi.