AI tizim bilan ishlaganda eng qiyin savollardan biri: natija yaxshilandimi yoki yo‘qmi? Promptni o‘zgartirdingiz, modelni almashtirdingiz, RAG qo‘shdingiz. Endi buning foydasi bo‘ldimi? Bu savolga sezgi bilan emas, o‘lchov bilan javob berish kerak.
Shu yerda evalAI javobi qanchalik to‘g‘ri, foydali yoki barqaror ekanini oldindan belgilangan mezonlar bilan baholash jarayoni. tushunchasi paydo bo‘ladi. EvalAI javobi qanchalik to‘g‘ri, foydali yoki barqaror ekanini oldindan belgilangan mezonlar bilan baholash jarayoni. - AI tizim natijasini oldindan belgilangan mezonlar asosida tekshirish jarayoni. Bu mahsulot sifatini barqaror boshqarish uchun kerak va observability bilan birga kuchliroq ishlaydi. Kengroq jarayon sifatida esa bu AI mahsulotni to‘liq tekshirish ishining markaziy qismi.
EvalAI javobi qanchalik to‘g‘ri, foydali yoki barqaror ekanini oldindan belgilangan mezonlar bilan baholash jarayoni. nima?
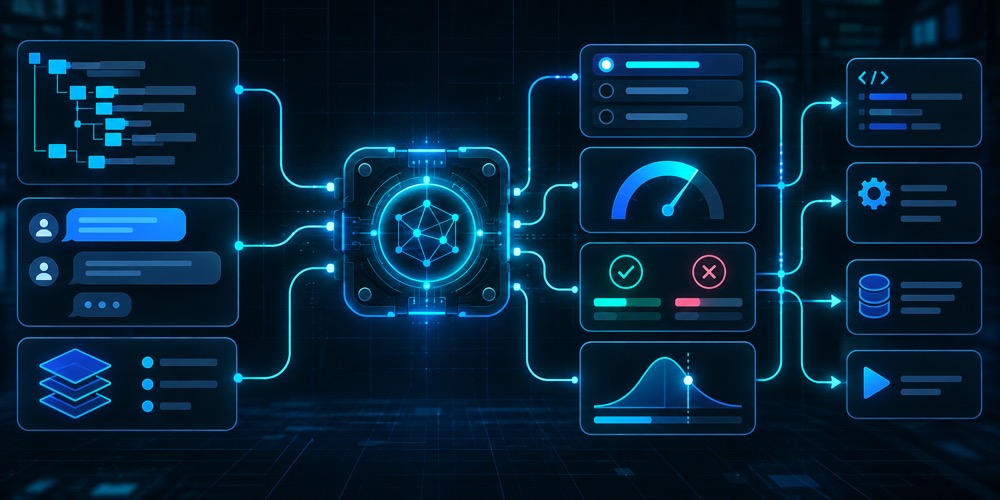
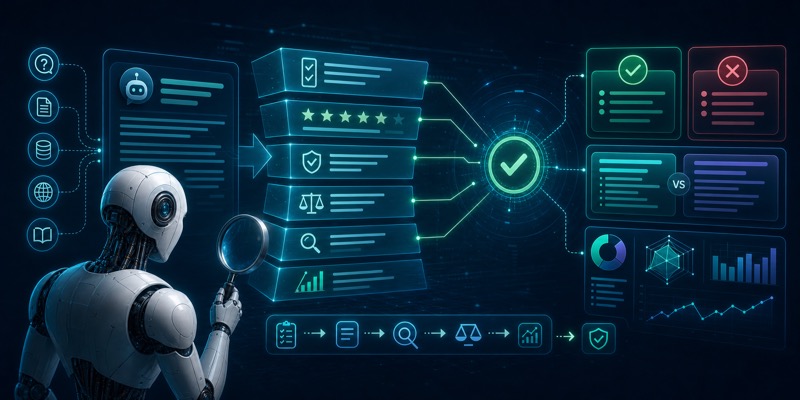
EvalAI javobi qanchalik to‘g‘ri, foydali yoki barqaror ekanini oldindan belgilangan mezonlar bilan baholash jarayoni. - model yoki butun AI jarayonini test to‘plami va aniq mezonlar asosida baholash usuli. U biror o‘zgarishdan keyin sifat oshdimi, pasaydimi yoki umuman farq bo‘ldimi degan savolga javob beradi.
Bu faqat modelning o‘zini emas, retrieval, promptModelga berilgan ko‘rsatma yoki topshiriq matni. Javob sifati ko‘pincha shu kirishga bog‘liq bo‘ladi., tool use va output format kabi qatlamlarni ham tekshirishi mumkin.
Nega evalAI javobi qanchalik to‘g‘ri, foydali yoki barqaror ekanini oldindan belgilangan mezonlar bilan baholash jarayoni. kerak?
- o‘zgarishlarning foydasini o‘lchash uchun,
- regressiyani erta topish uchun,
- turli model va promptlarni solishtirish uchun,
- mahsulotni hissiyot bilan emas, dalil bilan yaxshilash uchun.
Agar evalAI javobi qanchalik to‘g‘ri, foydali yoki barqaror ekanini oldindan belgilangan mezonlar bilan baholash jarayoni. bo‘lmasa, “bu promptModelga berilgan ko‘rsatma yoki topshiriq matni. Javob sifati ko‘pincha shu kirishga bog‘liq bo‘ladi. yaxshiroq ko‘rindi” yoki “bu model aqlliroqdek” kabi noaniq xulosalarga tayanib qolish oson.
Nimani o‘lchash mumkin?
- to‘g‘rilik,
- relevance,
- manbaga tayanish,
- formatga moslik,
- xavfsizlik va policy’ga moslik,
- latency va narx.
Masalan, support bot uchun eng muhim mezon foydali va to‘g‘ri javob bo‘lishi mumkin. Kod assistenti uchun esa syntax to‘g‘riligi, requirement’ga moslik va testdan o‘tish muhimroq bo‘ladi. Agar tizim agentga o‘xshab amaliy harakat qilsa, agent va chatbot farqi ham baholash mezonlariga ta’sir qiladi.
EvalAI javobi qanchalik to‘g‘ri, foydali yoki barqaror ekanini oldindan belgilangan mezonlar bilan baholash jarayoni. dataset qanday tuziladi?
Yaxshi evalAI javobi qanchalik to‘g‘ri, foydali yoki barqaror ekanini oldindan belgilangan mezonlar bilan baholash jarayoni. uchun real hayotga yaqin testlar kerak. Odatda quyidagilar yig‘iladi:
- odatiy foydalanuvchi so‘rovlari,
- qiyin edge-case’lar,
- noto‘g‘ri yoki noaniq so‘rovlar,
- yuqori xavfli holatlar,
- format talab qilinadigan vazifalar.
Dataset kichik bo‘lsa ham foydali bo‘lishi mumkin, lekin u real mahsulot muammolarini aks ettirishi kerak. Sun’iy va haddan tashqari toza misollar evalni chiroyli ko‘rsatadi, ammo amaliy foydasi past bo‘ladi.
Baholash qo‘lda bo‘ladimi yoki avtomatik?
Ikkalasi ham ishlatiladi. Qo‘lda baholash sifatli insight beradi, lekin sekin va qimmat. Avtomatik baholash tezroq, lekin noto‘g‘ri mezon tanlansa, chalg‘itishi mumkin.
Ko‘p jamoalar gibrid yondashuvdan foydalanadi: asosiy regression testlar avtomatik bo‘ladi, nozik sifat farqlari esa qo‘lda ko‘rib chiqiladi.
LLMLarge Language Model qisqartmasi. Katta matn korpuslarida o‘qitilgan va til bilan ishlaydigan model turi.-as-a-judge yetarlimi?
Ba’zan boshqa model yordamida javobni baholash mumkin, lekin bu confidence score kabi signallar bilan aralashib ketmasligi kerak. Bu tez va qulay. Lekin buni yagona haqiqat deb qabul qilish xato. Judge modelning o‘zi ham tarafkash yoki noaniq bo‘lishi mumkin.
Shuning uchun iloji bo‘lsa, aniq qoidali tekshiruvlar, reference answer, structured scoring va inson nazorati bilan birga ishlatish yaxshiroq.
Xulosa
EvalAI javobi qanchalik to‘g‘ri, foydali yoki barqaror ekanini oldindan belgilangan mezonlar bilan baholash jarayoni. - AI mahsulotni professional darajada boshqarish uchun zarur qatlam. U promptModelga berilgan ko‘rsatma yoki topshiriq matni. Javob sifati ko‘pincha shu kirishga bog‘liq bo‘ladi., model, retrieval yoki tool useModel yoki agentning brauzer, API, terminal, fayl tizimi yoki boshqa tashqi vositalardan foydalanishi.’dagi o‘zgarishlarni dalil bilan baholashga yordam beradi. Bu qatlam hallucinationni kamaytirish ishida ham foydali. Agar yaxshilanishni o‘lchay olmasangiz, uni barqaror takrorlay olmaysiz ham.